Ldfa
-
Compteur de contenus
30 424 -
Inscription
-
Dernière visite
-
Jours gagnés
1 219
Type de contenu
Profils
Forums
Calendrier
Tout ce qui a été posté par Ldfa
-
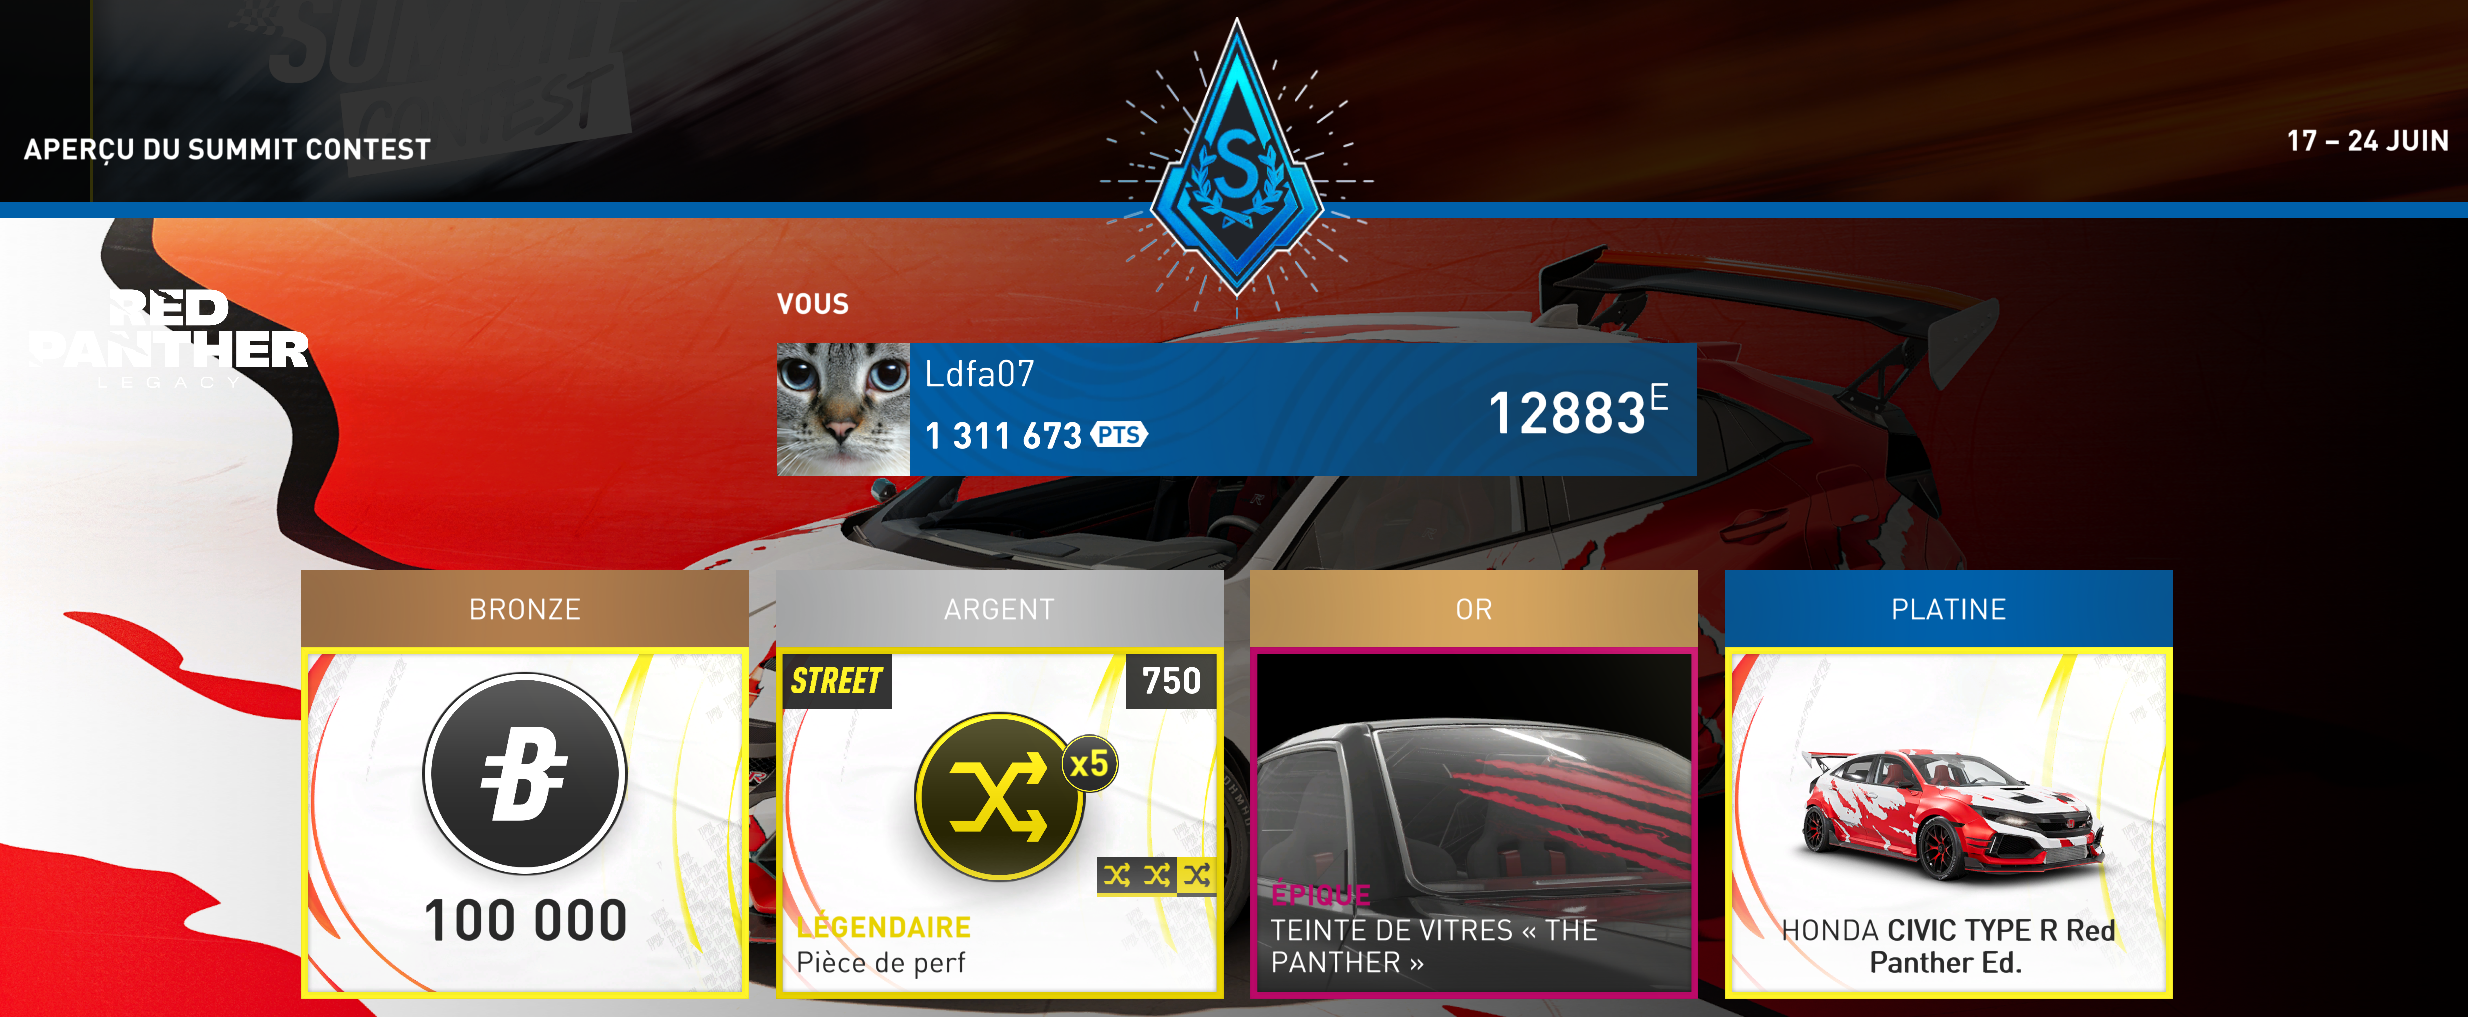
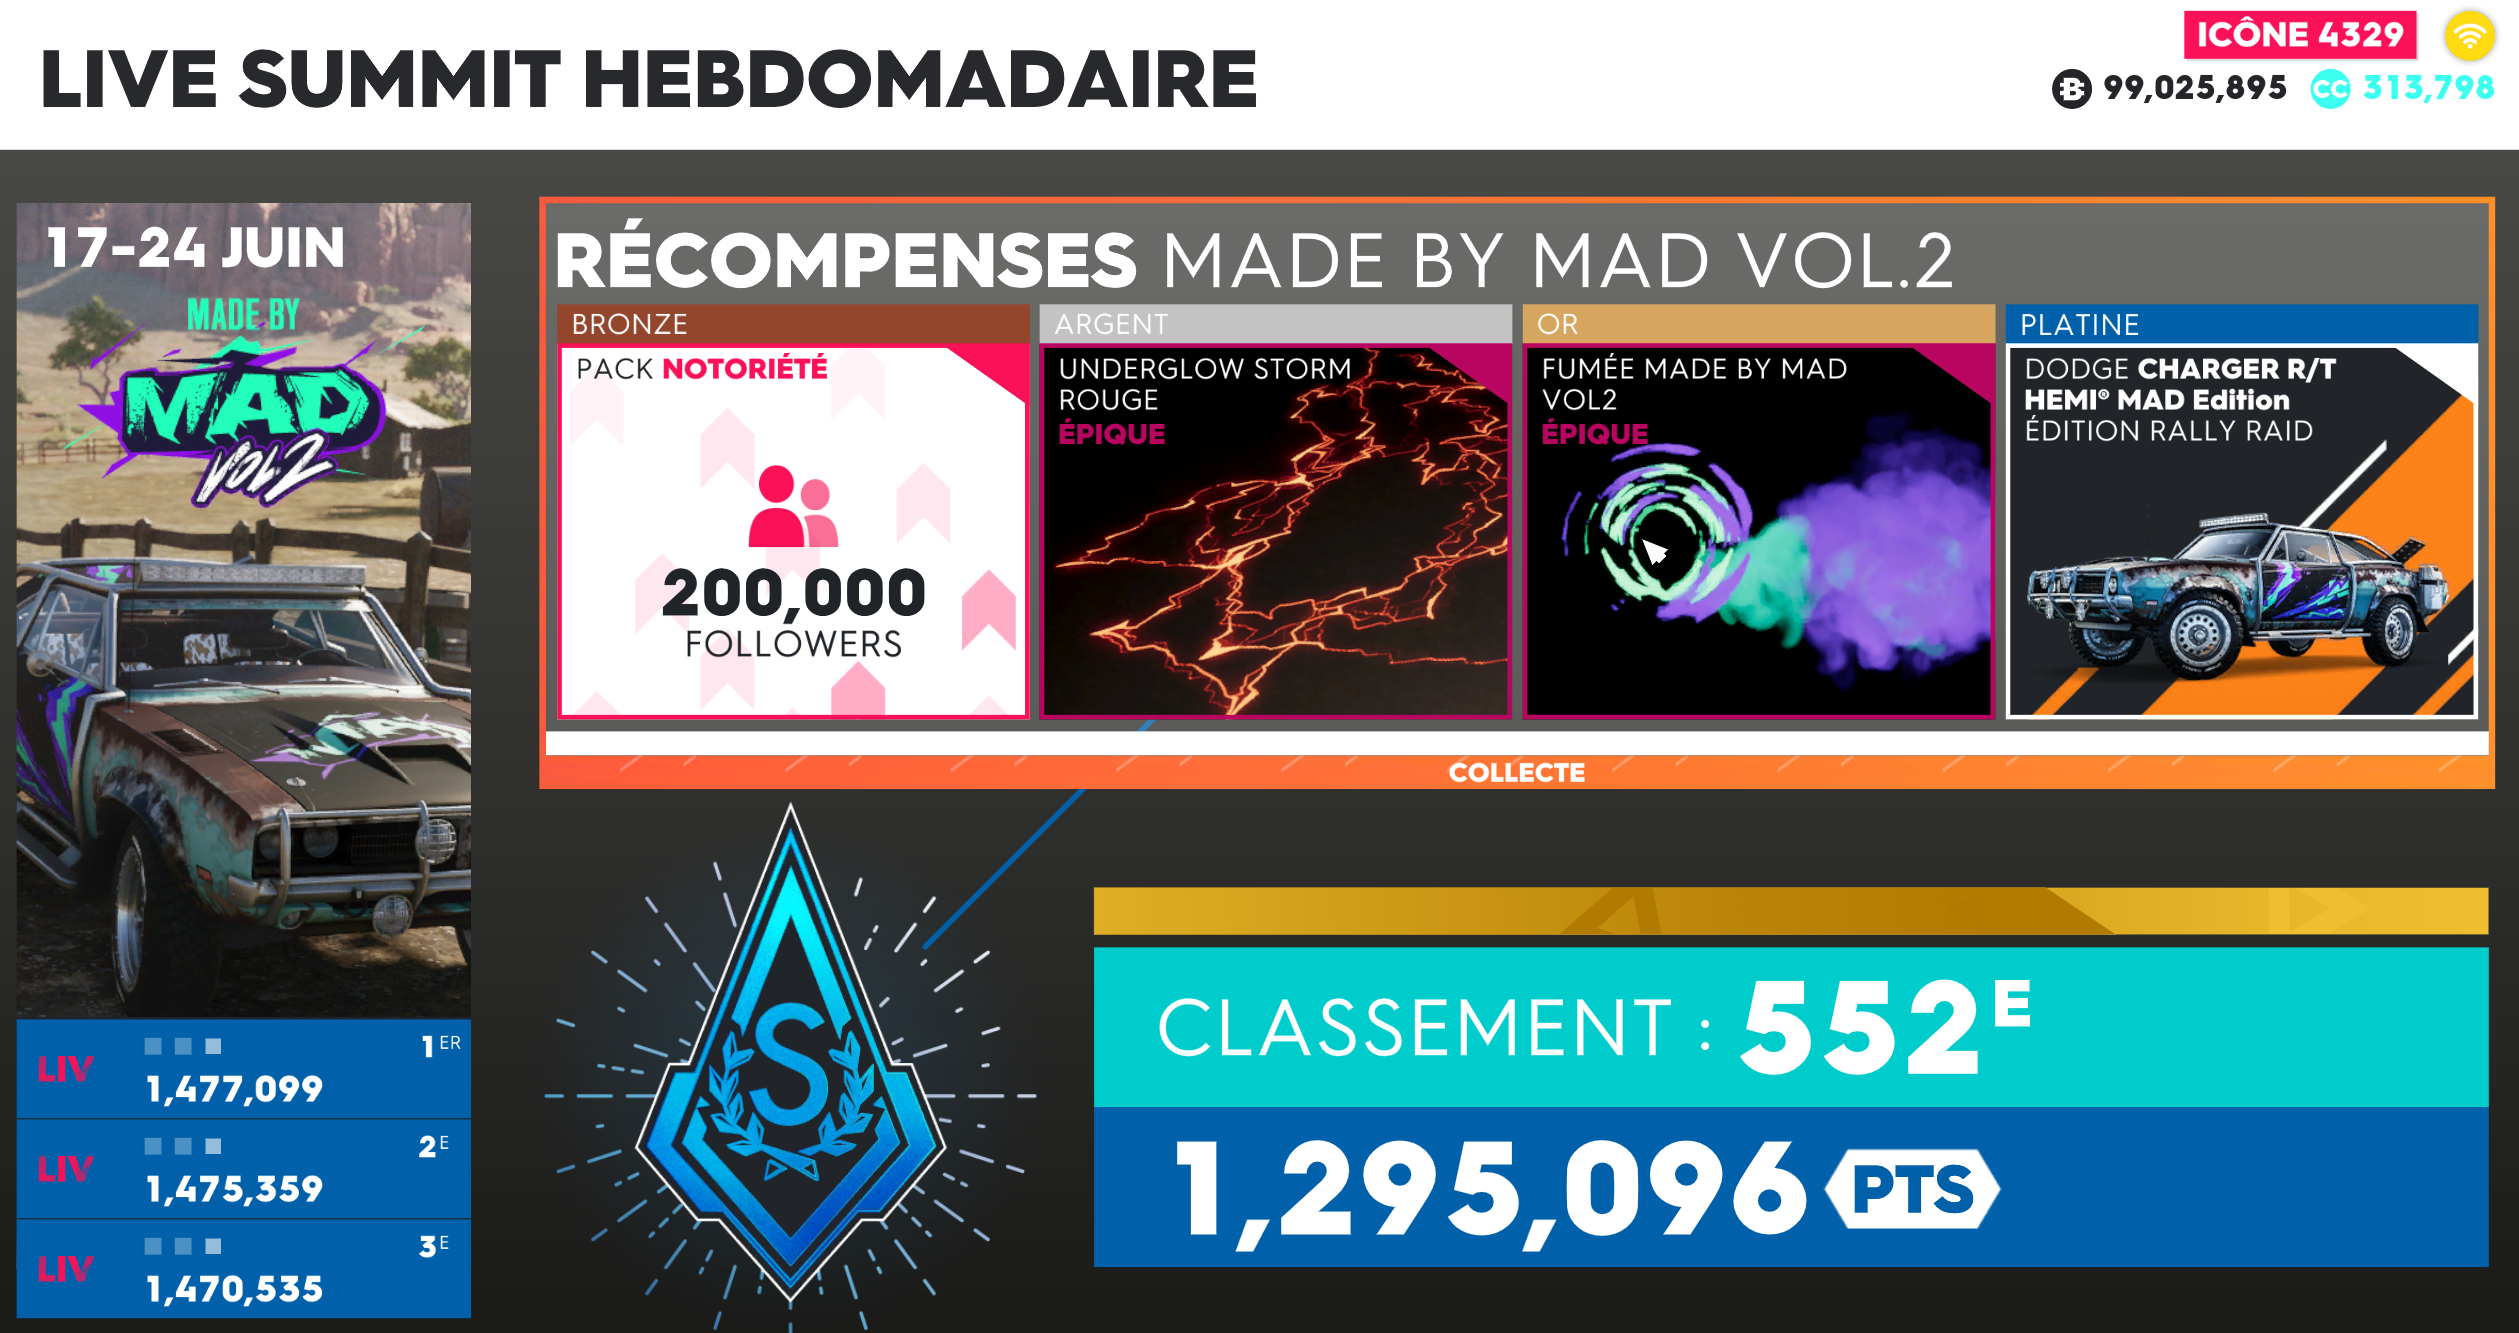
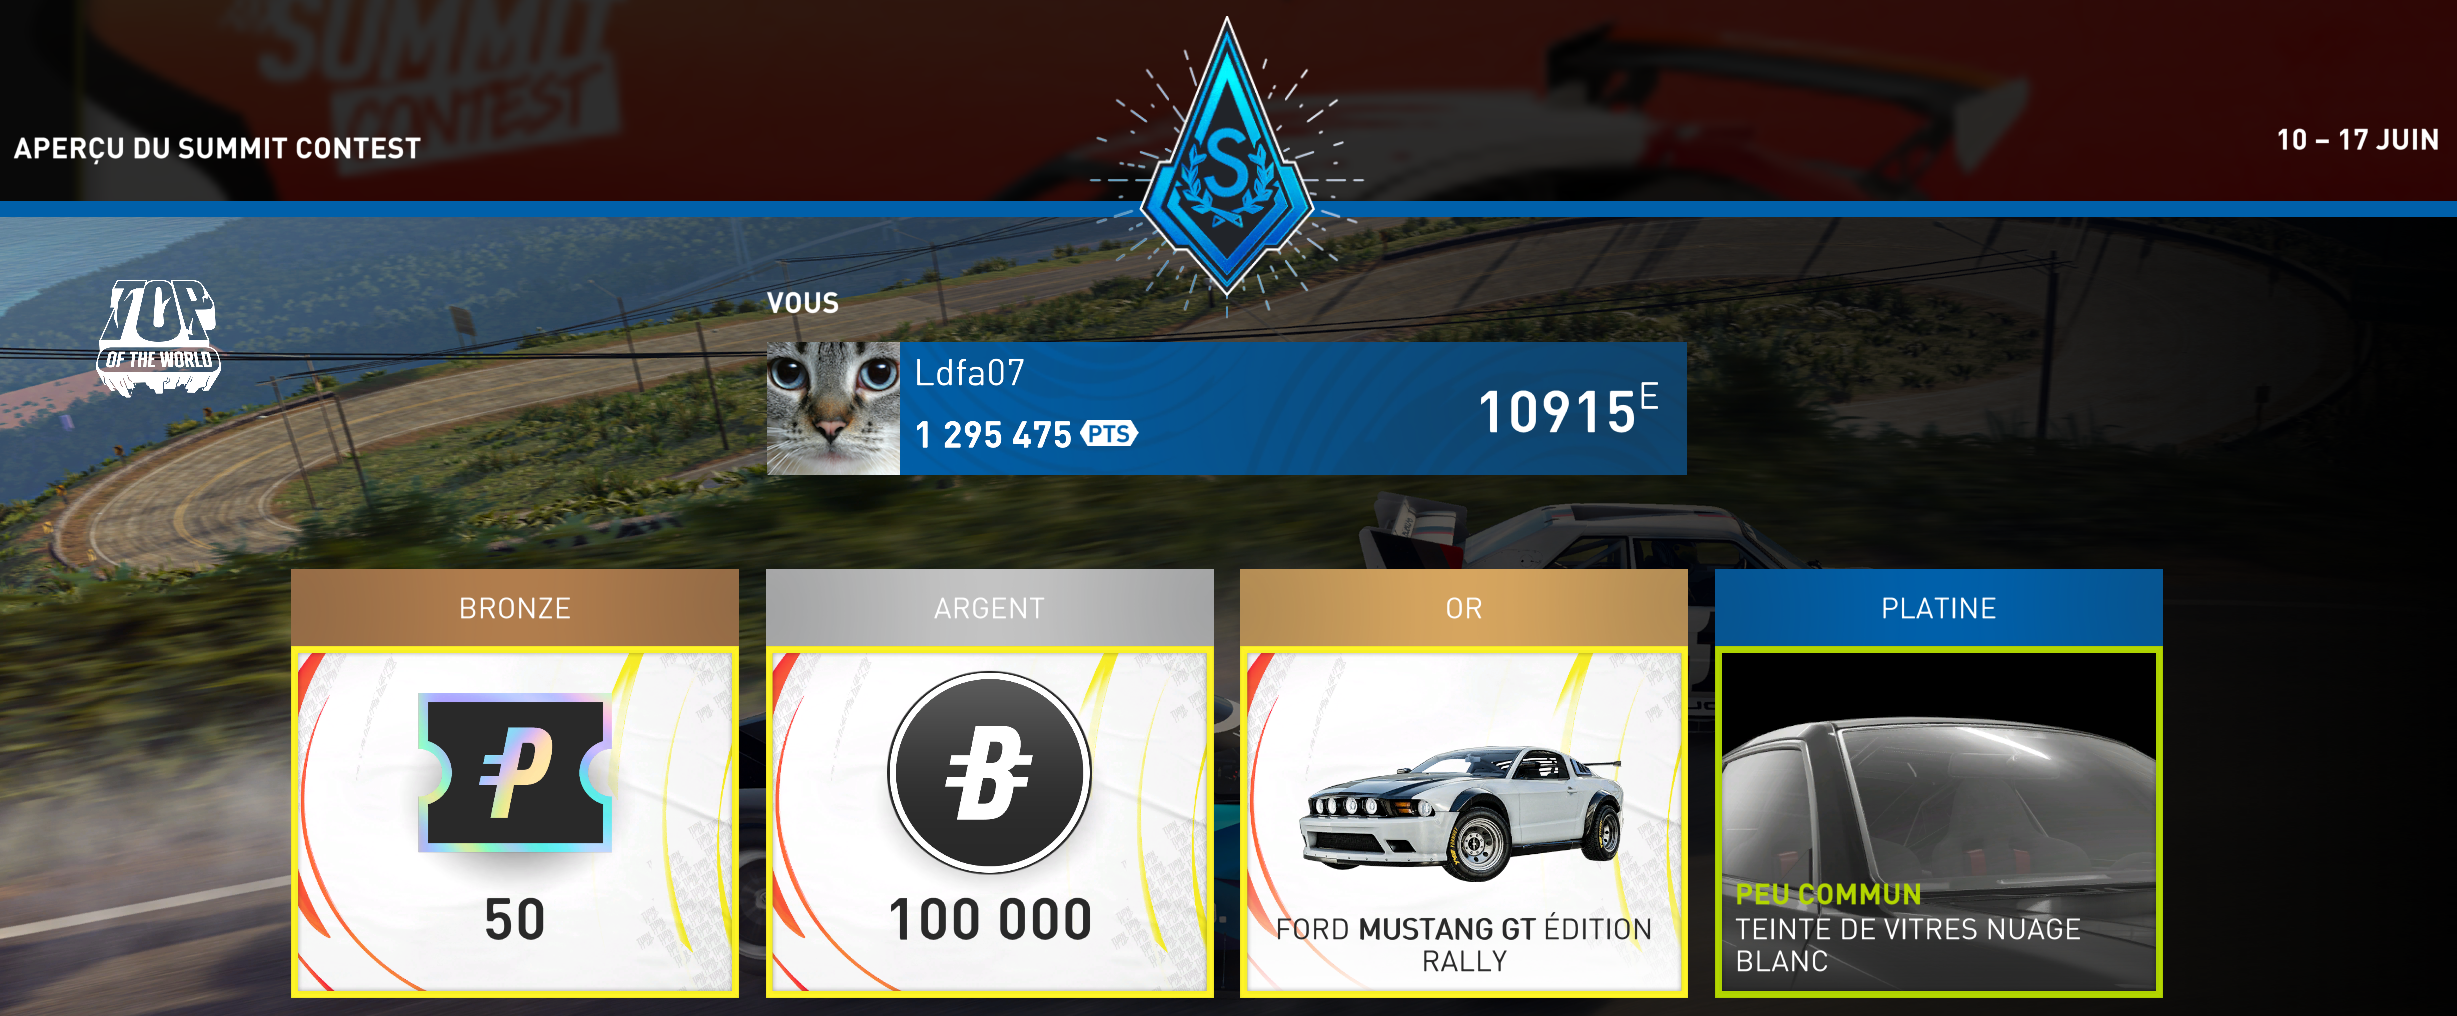
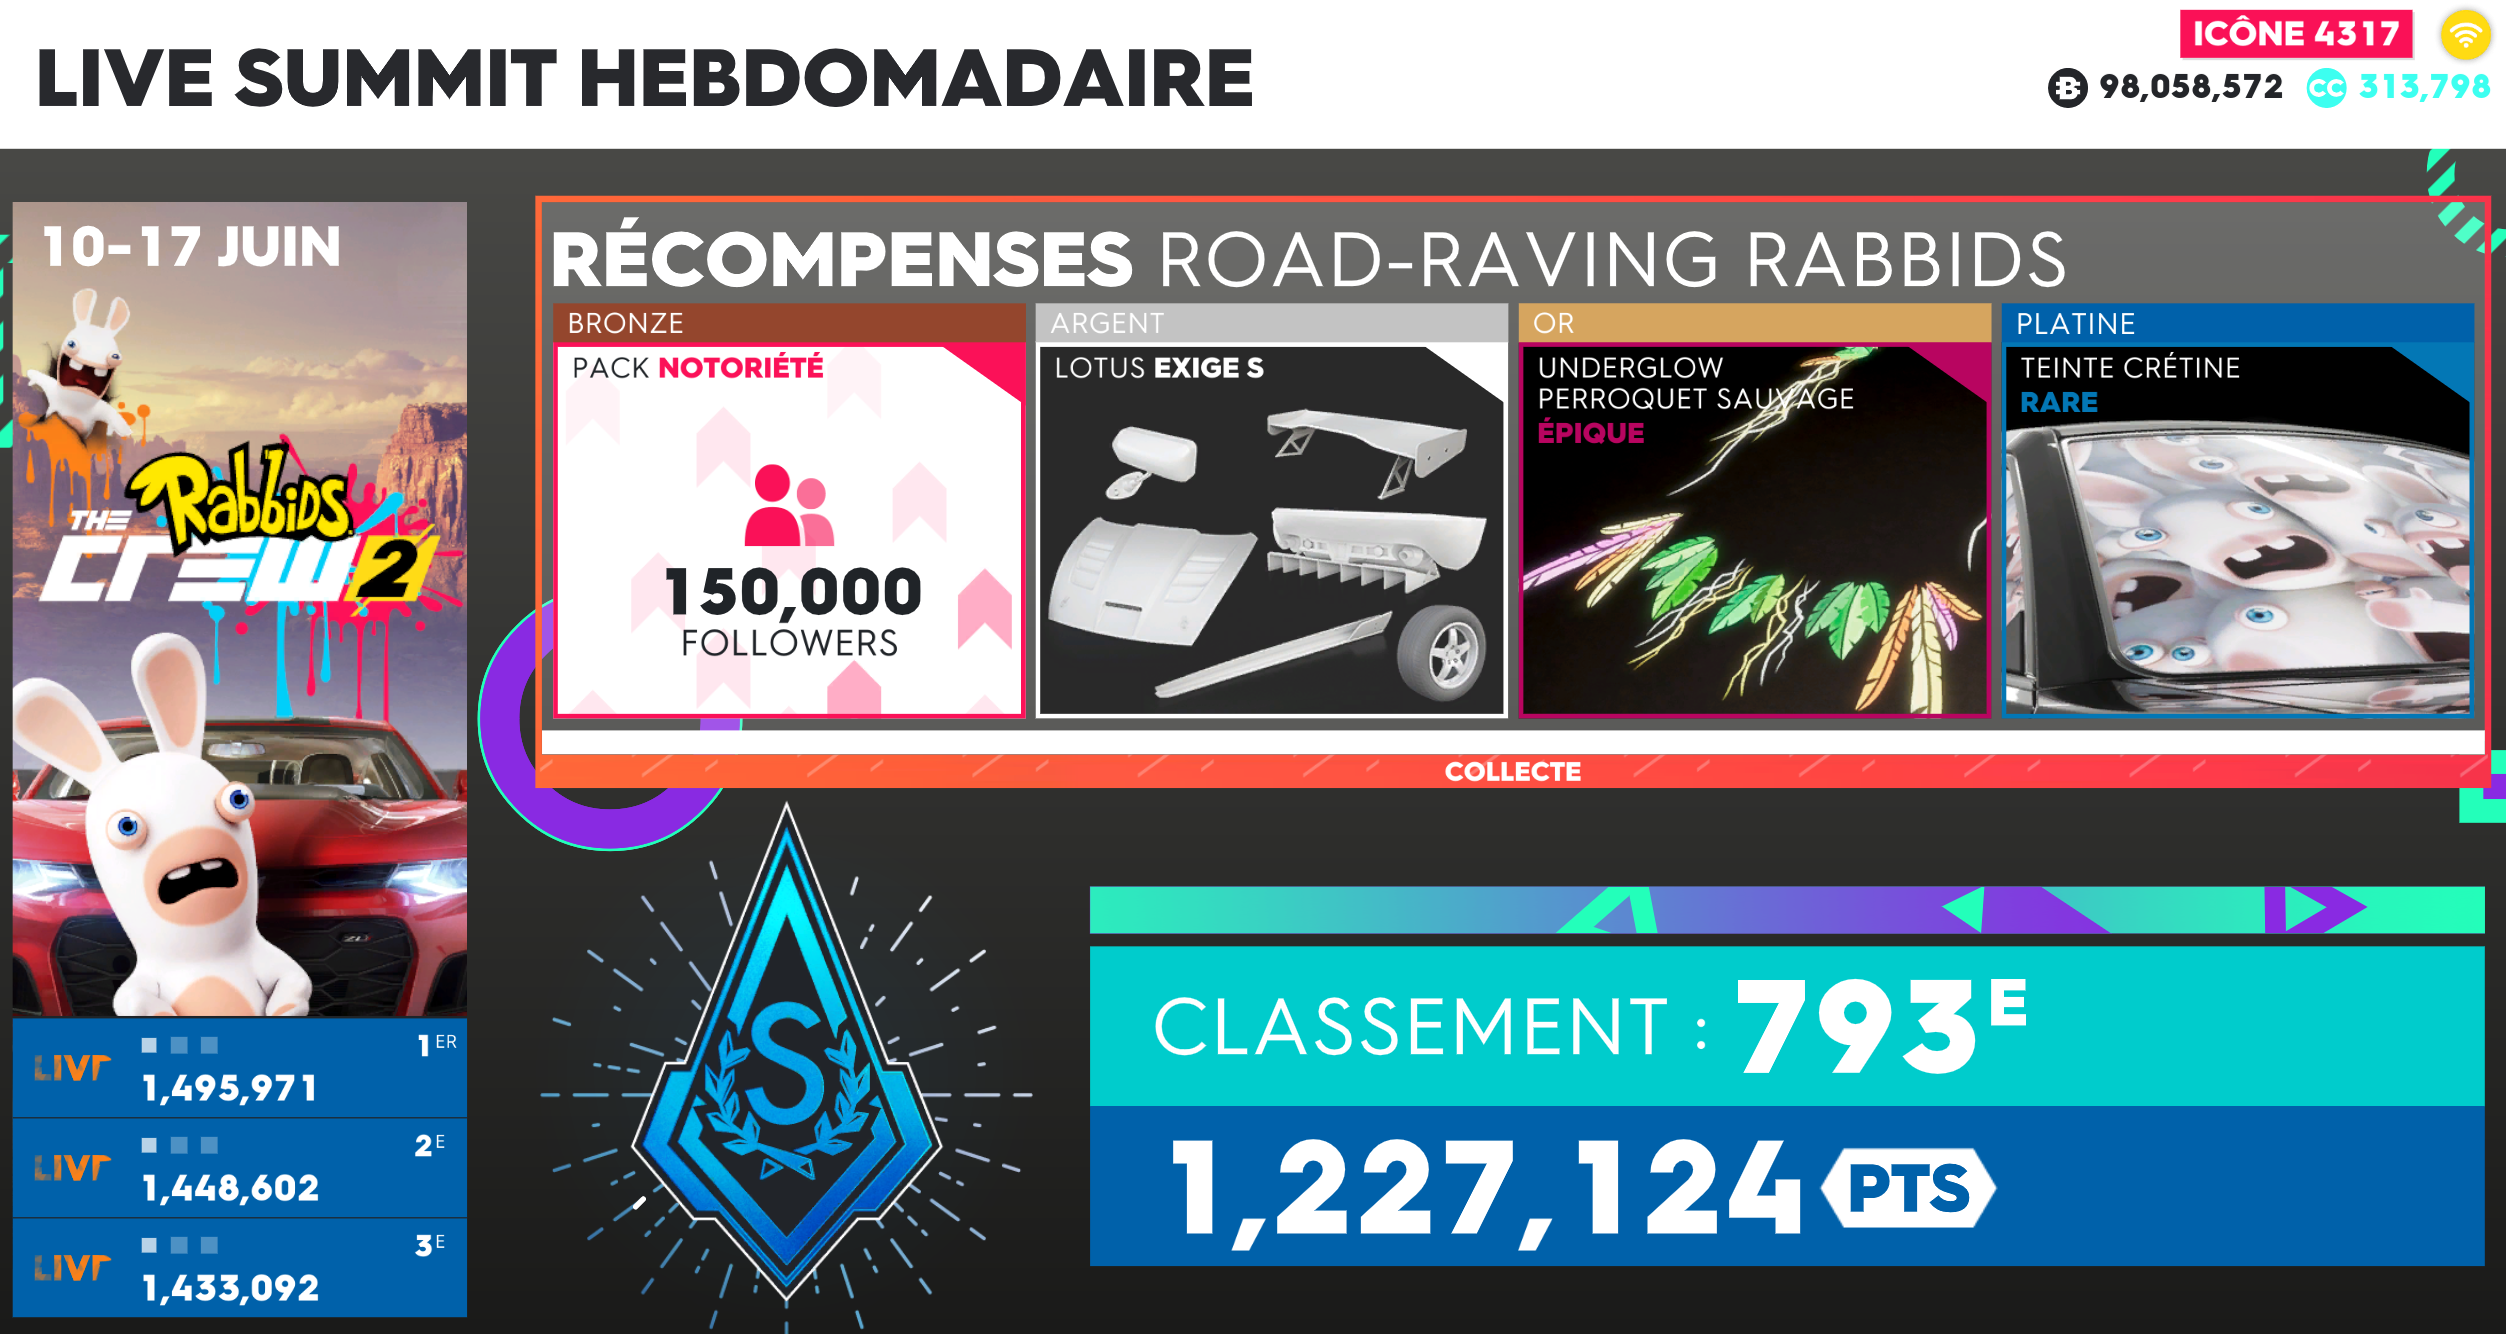
Je termine encore Platine cette semaine.

-
IA Mon nouvel ami qui sait tout sur tout #chatGPT - Korben.info
Ldfa a répondu à un(e) sujet de Ldfa dans Mon Wallabag
Mistral Vibe serait le plus respectueux : https://www.clubic.com/actualite-619279-cocorico-le-francais-mistral-ai-est-le-vrai-bon-eleve-sur-la-collecte-des-donnees-catastrophe-pour-meta-ai.html -
Audiobook Alexandria - Vos ebooks en livres audio multi-voix, en local - Korben
Ldfa a posté un sujet dans Mon Wallabag
Korben Publié le 29 juin 2026 Par Korben, Manuel Dorne korben.info Environ 3 minutes de lecture Je ne suis pas très client des livres audio parce que mon cerveau, en général, part faire des trucs dans son coin et je me retrouve à rien écouter du tout. Je préfère un petit podcast où ça rigole qu'une œuvre littéraire qui demande de la concentration. Mais je sais que vous appréciez beaucoup les livres audio et il arrive très souvent qu'un bouquin n'ait pas sa version audio. Un vieux roman qui n'est plus édité, un PDF technique, une fanfiction de 800 pages, un article de korben.info ou juste un truc que personne chez Audible ne prendra le temps d'enregistrer parce que ça n'intéresse que vous. Mais youpi, Finrandojin, un internaute, en a eu marre d'attendre l'audiobook de ses rêves et a codé Alexandria, un générateur de livre audio qui tourne 100% en local sur votre ordi. Vous balancez un fichier .txt, .md ou .epub, dans l'appli, puis un LLM découpe le texte et annote chaque ligne avec le personnage qui parle et la manière dont il le dit, puis le moteur Qwen3-TTS joue le tout en local comme une vraie troupe de doubleurs professionnels. Et le résultat est assez propre, même si ça ne vaut pas encore un vrai enregistrement fait par un vrai humain. M'enfin, faute de mieux, pourquoi pas ! Et surtout, ce LLM qui fait le découpage, vous le branchez où vous voulez. En local via LM Studio ou Ollama, ou dans le cloud avec OpenAI ou n'importe quelle API compatible. Ensuite, une fois le script annoté, Alexandria vous propose 9 voix pré-entraînées avec contrôle de l'émotion et du ton. Vous pouvez aussi cloner une voix à partir de 5 à 15 secondes d'échantillon, ou carrément en fabriquer une à partir d'une simple description écrite. Vous tapez par exemple "Une voix masculine chaude et grave, au ton calme et posé" (c'est ma voix quoi...lol) et hop, il vous la fabrique. La fonctionnalité de génération de personnas fait également gagner un temps de dingue puisqu'en un clic, le LLM analyse le bouquin, invente une description de voix pour chaque personnage, génère l'audio de référence et assigne tout automatiquement. Et pour les obsédés du détail, il y a même un éditeur web où vous regénérez n'importe quelle ligne individuellement, du training LoRA pour vous fabriquer des voix persistantes, et un export en MP3 en pistes séparées pour bidouiller ça ensuite dans Audacity, ou en M4B chapitré qui rentre direct dans Audiobookshelf, Apple Books ou VLC. Et tout ça bien sûr, dans une dizaine de langues, français compris. Alexandria exigera par contre une carte graphique avec 8 Go de VRAM au minimum, 16 et plus si vous voulez du débit correct. Et si vous êtes sur Mac, mauvaise nouvelle, l'accélération MPS d'Apple Silicon n'est pas encore supportée, donc ça tournera en mode CPU, donc ce sera lent. Mais c'est pas très grave, vous lancez la génération, et vous retournez lire d'autres articles sur mon site pour passer le temps. Même galère aussi pour les gens qui ont de l'AMD sous Windows. Les chanceux par contre, ce sont les possesseurs de NVIDIA sous Windows ou Linux et les AMD sous Linux. Maintenant si vous tenez juste à faire parler votre Mac sans y passer trois heures par chapitre , vous serez mieux servi ailleurs qu'avec Alexandria. Pour l'installation, le plus simple passe par Pinokio en deux clics, et si vous n'avez pas le GPU qui va bien, il y a un notebook Google Colab pour tourner sur un T4 gratuit dans le navigateur. Comptez quand même un téléchargement de 3,5 Go pour les modèles TTS à la première utilisation, ils ne sont pas inclus dans l'install. Vous l'aurez compris, c'est du DIY un peu gourmand en GPU, mais pour tous vos ebooks à écouter qui n'auront jamais de narrateur, ça ouvre les perspectives ! Le code est sous licence MIT et je vous invite quand même à tester avec un chapitre avant de vous lancer dans un roman entier. Source Afficher l’article complet
-
Je me suis permis également de poster l'annonce sur le FI qui est moribont depuis quelques temps... https://forum.maxthon.com/d/5573-maxthon-pc-7528600
-
Changements principaux : - Correction d'un problème empêchant la synchronisation des notes Maxnote présentant des structures particulières. - Correction d'un problème empêchant la prise en compte simultanée des modifications effectuées dans la barre latérale de Maxnote et dans la fenêtre contextuelle des notes. - Correction d'un problème d'affichage avec Uumail dans la barre latérale. - Correction d'un problème de sécurité lié aux vérifications d'autorisations lors de la consultation de mots de passe en texte clair dans Passkeeper. - Correction d'un problème empêchant la fonction « Enregistrement rapide d'image » d'enregistrer une image avec un nom de fichier vide.
-
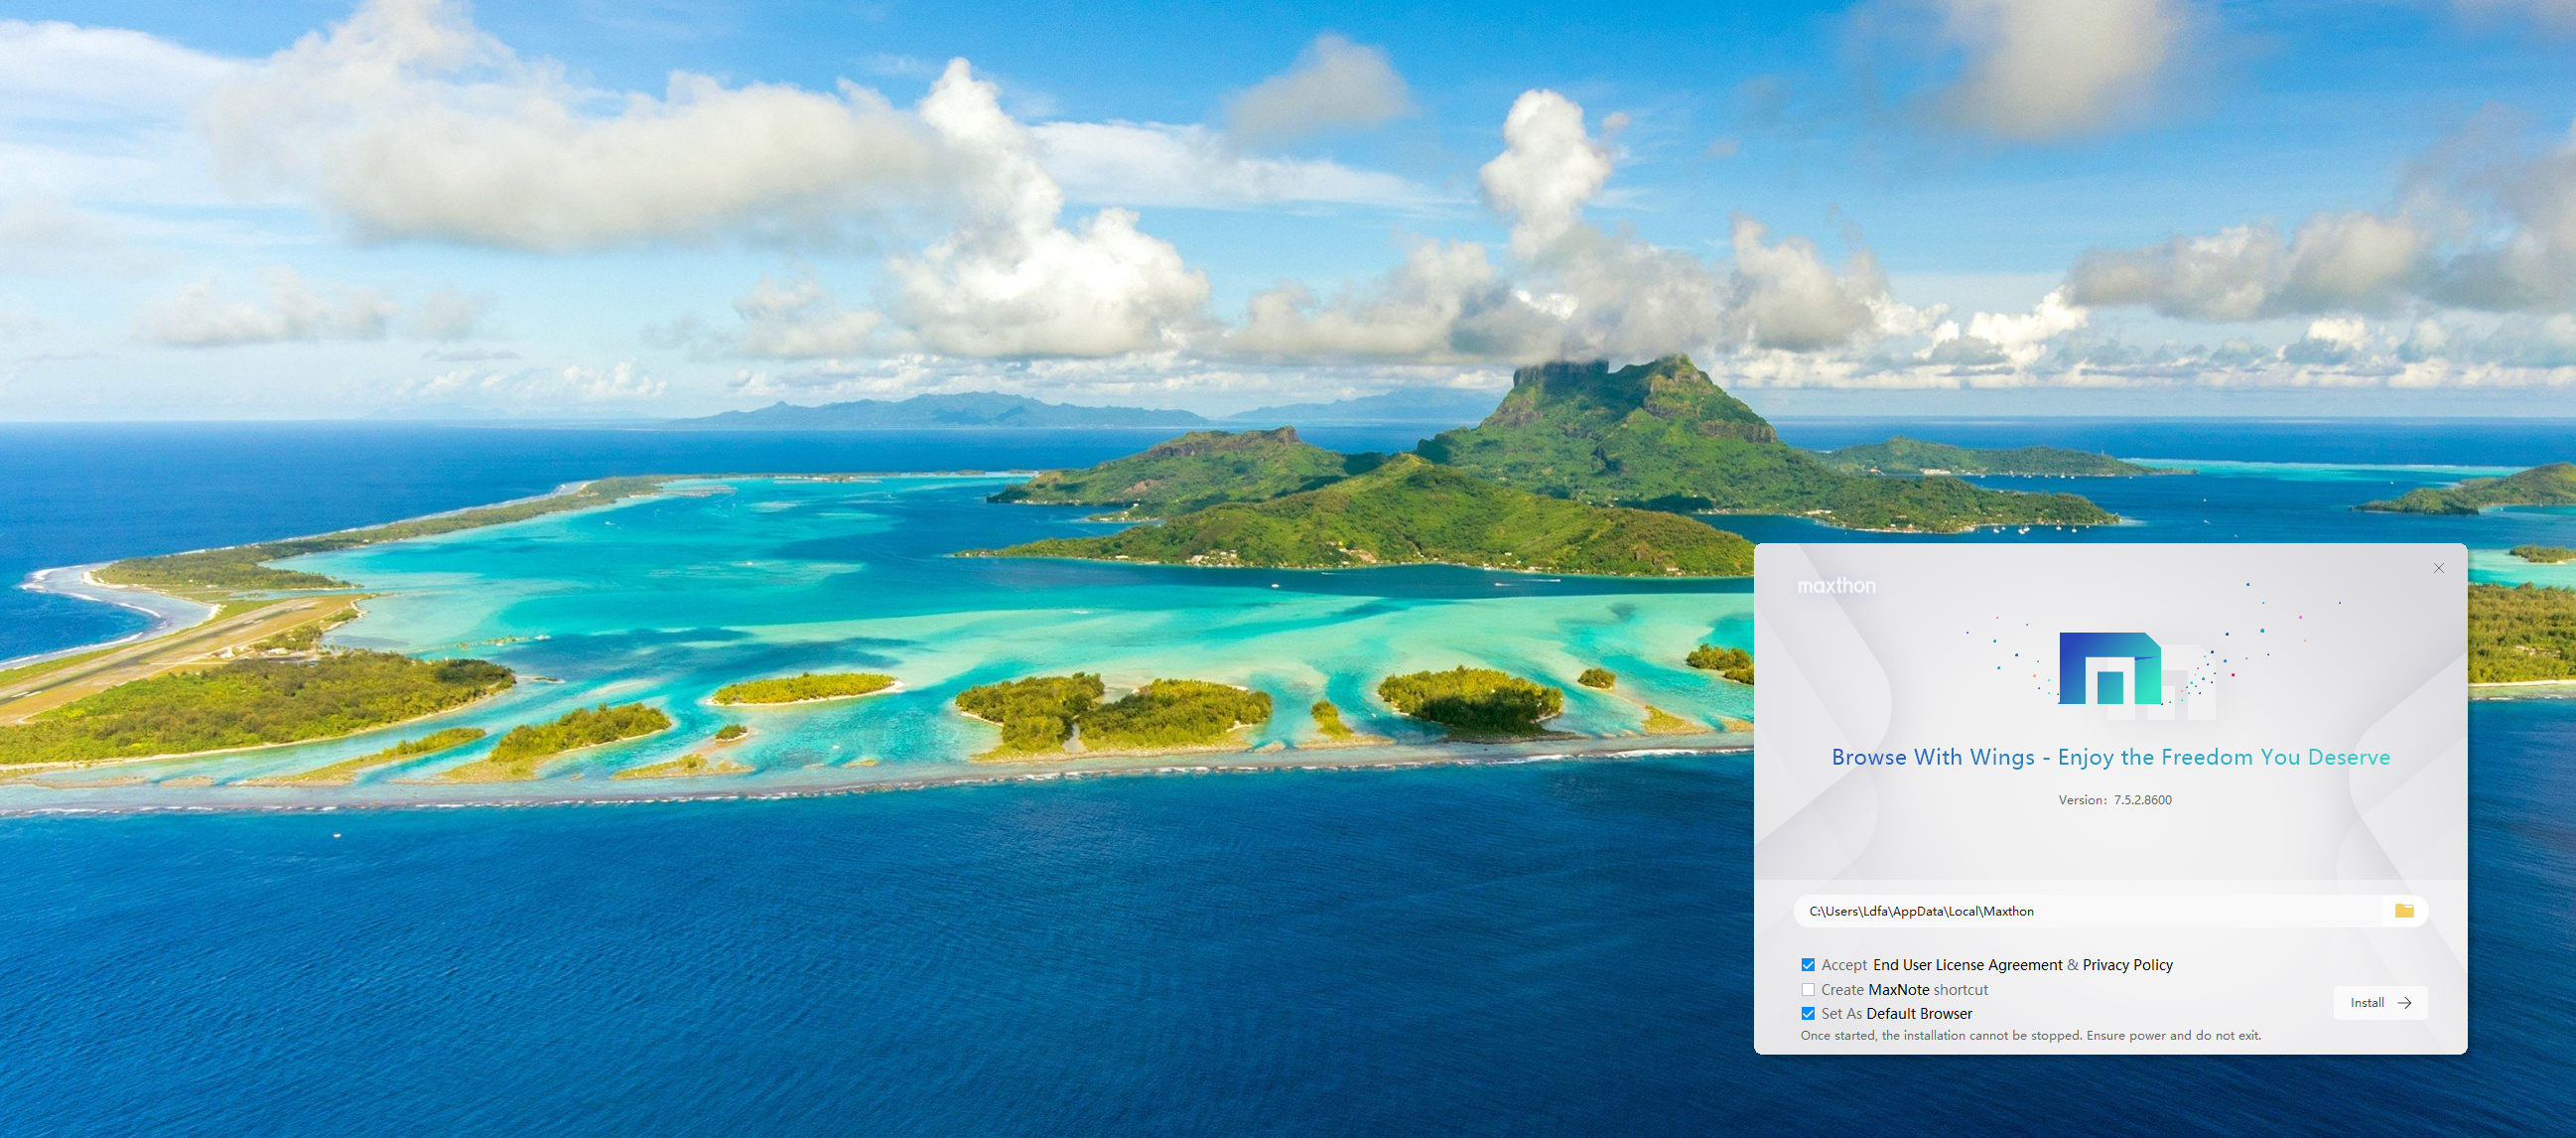
Maxthon 7.5.2.8600 Bêta pour Windows est sorti aujourd'hui, il apporte son lot de nouvelles fonctionnalités, d'améliorations et de corrections de bugs. Téléchargement : https://github.com/maxthon/Maxthon/releases/tag/7.5.2.8600 Les changements en français sont là. Vous pouvez également vous abonner au groupe Telegram NBdomain & MX6 pour faire remonter vos demandes d'améliorations et bugs rencontrés. Source : https://forum.maxthon.com/d/5573-maxthon-pc-7528600
-
Geeek.org Publié le 27 juin 2026 Par Ludovic Toinel geeek.org Environ 11 minutes de lecture J'ai pour habitude de présenter mon portfolio comme tout le monde : une page, une bio, quelques liens. Cette fois, j'ai eu envie de quelque chose de moins sage. Terminal.com[1] est un portail personnel qui prend la forme d'un terminal en plein écran : vous y arrivez, une fausse connexion SSH s'établit, le motd s'affiche, et la main vous est rendue. À partir de là, tout se visite à la commande. Au départ, l'objectif était purement esthétique : retrouver l'allure d'un terminal phosphore, écran vert type CRT avec sa pluie de caractères façon Matrix, ou monochrome ambré, scanlines, grain et curseur qui clignote. Puis le projet a dérivé vers quelque chose de plus intéressant : reproduire le fonctionnement réel d'un shell, entièrement côté navigateur, et lui greffer une capacité d'intelligence artificielle locale. C'est cette seconde partie qui m'a occupé le plus longtemps, et dont je veux vous parler ici. Tester directement, sans rien installer (un navigateur récent compatible WebGPU suffit) : Démo complète du terminal : https://ludovic.toinel.com/ webllmfit, pour savoir quels modèles votre machine peut charger : https://ludovic.toinel.com/webllmfit/ miaougpt, le chatbot : https://ludovic.toinel.com/miaougpt/ denree, l'agent autonome (alias ?) : https://ludovic.toinel.com/denree/ glaude, l'usine à sites façon 1997 : https://ludovic.toinel.com/glaude/ Un shell complet, sans serveur Le site est statique. Il est construit avec Astro[2] et Tailwind CSS, sans framework JavaScript côté client pour le rendu : tout le poids fonctionnel tient dans un moteur de shell maison. Le point que je trouve le plus satisfaisant, cela reste le faux système de fichiers. Ce n'est pas une simulation en mémoire : c'est une véritable arborescence sur disque, dans un dossier root/, que le build parcourt pour générer l'arbre de fichiers et le registre des commandes. Chaque commande est un simple fichier Markdown dans root/bin/. Pour comprendre comment, il faut s'arrêter une seconde sur une notion que peu de monde connaît en dehors des habitués des générateurs de sites statiques : le frontmatter. Le frontmatter, c'est un petit bloc de métadonnées placé tout en haut d'un fichier texte, délimité par deux lignes de trois tirets, et rédigé le plus souvent en YAML sous forme de paires clé/valeur. Le corps du document vient ensuite. Cette convention, héritée d'outils comme Jekyll puis reprise par Hugo, Astro et beaucoup d'autres, permet au générateur de lire le titre, la date ou les tags d'un article sans que ces informations ne se mélangent au contenu lui-même. La plupart des gens qui écrivent en Markdown ignorent jusqu'à son existence, alors qu'ils en croisent presque à chaque fois qu'ils touchent à un site statique. Dans Terminal.com, je détourne ce mécanisme pour décrire mes commandes. Le frontmatter porte le nom, la description, d'éventuels alias, une page de manuel, et un bloc js qui est exécuté si la commande est dynamique. Une commande sans js affiche simplement son corps Markdown. Voici par exemple la commande date au complet : --- name: date desc: date et heure js: | ctx.line(new Date().toString()); --- Ajouter une commande revient donc à déposer un fichier Markdown, et le moteur la découvre toute seule. Ce bloc js reçoit un objet ctx qui expose tout ce dont une commande a besoin : les arguments, des fonctions d'affichage, des aides de temporisation, la saisie interactive, la navigation dans l'arborescence, et les mutations persistantes du système de fichiers (les mkdir, touch et rm sont conservés par navigateur dans le localStorage). Côté commandes intégrées, j'ai cherché à couvrir l'essentiel d'un shell : navigation et manipulation de fichiers (ls, cd, cat, tree, find, grep), identité système (whoami, uname, su, theme), réseau (nslookup, ping, checkip, weather), un peu de crypto pour le plaisir (base64, sha256sum, et même un hashcat qui force du MD5 en multicœur via les Web Workers), sans oublier l'historique persistant, l'autocomplétion au Tab et l'édition de ligne à la Ctrl+A/E/U/K/W. Il y a aussi une commande msg qui m'envoie une notification Web Push, pratique pour recevoir un mot d'un visiteur même sans onglet ouvert. Un point de vigilance côté sécurité : les commandes dynamiques s'exécutent via AsyncFunction, donc une forme d'eval. La politique de sécurité de contenu déployée est une couche de durcissement, pas un bac à sable, puisqu'elle doit autoriser unsafe-eval pour le moteur. Il ne faut donc charger que des commandes de confiance. C'est un compromis assumé pour un portail personnel mono-auteur. Le pari : embarquer un LLM dans le terminal La vraie originalité du projet, cela tient au mécanisme de chargement de LLM. J'utilise WebLLM[3], le moteur d'inférence du projet MLC qui exécute des modèles de langage directement dans le navigateur, accéléré par WebGPU[4], sans serveur et sans appel réseau pour l'inférence. L'API est compatible OpenAI, ce qui simplifie beaucoup l'intégration. Plutôt que de laisser chaque commande gérer son moteur dans son coin, j'ai centralisé toute la mécanique dans un module unique, propriétaire exclusif du moteur WebLLM. C'est le seul endroit qui télécharge les poids, conserve le moteur résident, lance les générations et comptabilise les tokens. Les commandes ne touchent jamais directement au moteur : elles passent par une façade qui leur fournit la demande de consentement et la barre de progression dans le terminal. L'état courant (modèle chargé, tokens consommés en entrée et en sortie, progression du téléchargement) vit sur un emplacement global et alimente un widget en haut à droite de l'écran. D'où viennent les modèles, et comment ils sont chargés Le moteur WebLLM lui-même, je l'héberge sur mon propre serveur, dans un fichier /vendor/web-llm-<version>.js d'environ 6 Mo. Il n'est pas embarqué dans la page : je le charge à la demande, par import dynamique, la toute première fois qu'une commande réclame un modèle, puis je le conserve pour la durée de la session. Tant que vous ne touchez à aucune commande d'IA, rien n'est téléchargé. Le catalogue des modèles, lui, est celui que WebLLM fournit par défaut, à savoir son registre prebuiltAppConfig. Lorsque vous confirmez un modèle, le moteur va chercher deux choses sur le réseau : les poids quantifiés, au format MLC, depuis Hugging Face (l'organisation officielle mlc-ai[5]), et la bibliothèque de calcul compilée pour WebGPU, un fichier WebAssembly fourni par le projet MLC. Une fonction de rappel sur la progression alimente la barre que vous voyez défiler dans le terminal. Les deux ressources sont ensuite rangées dans le cache du navigateur. Le second chargement du même modèle devient donc instantané et fonctionne hors ligne. Point important pour la confidentialité : ce téléchargement initial est le seul moment où le navigateur sort sur le réseau. L'inférence, elle, se déroule intégralement en local, sans le moindre appel vers un serveur. Quelques détails d'implémentation dont je suis assez content : Aucun modèle n'est chargé par défaut. Au premier usage, la commande propose un modèle et vous demande de confirmer son téléchargement. Rien ne part sans votre accord. Le module choisit automatiquement la bonne quantification selon votre carte graphique : il interroge l'adaptateur WebGPU et retient q4f16 si la fonctionnalité shader-f16 est disponible, sinon q4f32. Et si un GPU annonce le support f16 mais échoue à compiler les shaders, il bascule en q4f32 en repli. Les modèles sont mis en cache dans le navigateur. Une fois téléchargé, un modèle est réutilisé instantanément, y compris hors ligne, et je fournis de quoi lister et purger ce cache via la commande llm. Le modèle résident est partagé. Si vous l'avez chargé pour une commande, les deux autres le réutilisent sans rien retélécharger. Reste une question très concrète : quel modèle votre machine peut-elle réellement charger ? J'y réponds avec une commande dédiée, webllmfit, inspirée de llmfit.org, dont je vous parlais dans un précédent article, mais branchée sur le vrai catalogue WebLLM. Elle sonde les capacités WebGPU de la machine (l'adaptateur, le support de shader-f16, les tailles maximales de buffers) ainsi qu'une estimation de la mémoire disponible, puis croise ces informations avec la VRAM requise et les fonctionnalités exigées par chaque modèle. Chacun reçoit alors un verdict : FIT lorsqu'il tient confortablement, TIGHT lorsqu'il passe de justesse, NO lorsqu'il est trop gros ou réclame une fonctionnalité GPU absente. La liste est triée pour faire remonter en premier le plus gros modèle exécutable. Le budget mémoire reste une estimation, car les navigateurs n'exposent pas la VRAM totale, mais cela donne une idée fiable avant de lancer un téléchargement de plusieurs gigaoctets. Et pour piloter tout cela à la main, il y a la commande llm, qui sert de console au module central. Sans argument, elle affiche le modèle actuellement chargé et les tokens consommés en entrée et en sortie. llm --list énumère les modèles conseillés, llm --load <id> en charge un explicitement, et llm --unload libère la mémoire GPU. C'est aussi par elle que l'on change de modèle en cours de route, ou que l'on gère le cache du navigateur : llm --cache liste ce qui est stocké, llm --rm supprime un modèle et llm --rm-all vide tout. Les opérations de cache ne réclament d'ailleurs pas WebGPU et fonctionnent dans n'importe quel navigateur. L'argument qui me plaît le plus dans cette approche : vos échanges avec le modèle ne quittent jamais votre machine. Pas de serveur d'inférence, pas de clé d'API, pas de donnée envoyée ailleurs. Trois exemples de commandes pour démontrer les capacités de WebLLM Pour montrer ce que cette base permet, j'ai écrit trois commandes très différentes, du chatbot trivial à l'agent autonome. miaougpt, le chatbot de terminal miaougpt est le cas le plus simple : un chat en mode terminal. Vous écrivez, l'assistant répond, jeton par jeton en streaming. Il a une légère personnalité féline, glisse un miaulement de temps en temps, et répond dans votre langue. J'y ai ajouté la synthèse vocale via la Web Speech API : /voice fr-FR fait lire les réponses à voix haute. Le modèle par défaut est un Qwen2.5 1.5B, suffisant pour discuter. Denree, l'agent autonome appelé par "?" Denree est l'expérience la plus ambitieuse : une architecture d'agent capable de piloter les commandes du shell. Le nom est un clin d'œil à la Denrée, l'extraterrestre de La Soupe aux Choux[6]. Vous lui donnez un objectif en langage naturel, et il demande au modèle de choisir, étape par étape, quelle commande lancer. Il exécute la commande, lit sa sortie, la réinjecte dans le contexte, et recommence jusqu'à produire une réponse finale. Je l'ai associé à l'alias ?, donc on l'appelle très naturellement : ? comment créer un fichier ? quelle est mon ip Faire raisonner correctement un petit modèle de 1,5 milliard de paramètres a demandé plusieurs astuces que je détaille volontiers, parce que ce sont elles qui font la différence entre un agent qui boucle et un agent qui répond : À chaque tour, la décision du modèle est contrainte en JSON par génération guidée par schéma. L'agent ne part jamais en vrille : il renvoie toujours soit une commande à lancer, soit rien. Un mini-RAG lexical, un BM25 allégé en JavaScript pur sur les pages de manuel, sélectionne les commandes les plus pertinentes pour l'objectif et injecte leur syntaxe exacte dans le contexte. Un petit modèle devine très mal les options d'une commande ; lui rappeler le bon SYNOPSIS évite la majorité des boucles. La réponse finale n'est pas demandée au modèle pendant la boucle, mais extraite par une étape de synthèse séparée à partir des sorties réellement obtenues, avec une consigne stricte de ne rien inventer ni convertir. C'est ce qui rend le résultat fiable malgré la taille du modèle. Une liste d'interdiction protège l'utilisateur : les commandes à effet de bord ou de contrôle (rm, su, sudo, msg, open, et les commandes d'IA elles-mêmes) sont bloquées pour l'agent. Glaude, la note d'humour Glaude est plus léger, et complètement assumé comme tel. C'est une parodie de Claude Code, incarnée par le Glaude, le paysan bourbonnais du même film. Il en reprend l'allure, bannière, boîte d'accueil, invite ›, mais sa spécialité est de pondre des sites web volontairement hideux et flashy : fonds fluo, dégradés arc-en-ciel, Comic Sans, balises <marquee>, texte qui clignote, emojis partout. L'esthétique GeoCities de 1997, en somme. Au lancement, il amorce un projet sous votre répertoire personnel, comme le ferait un vrai agent de code, écrit un index.html de départ, puis vous laisse lui décrire la page. Un /show ouvre un faux navigateur pour admirer le carnage, et un /download empaquette le tout en archive ZIP, le tout en JavaScript pur. Il s'appuie sur des modèles Qwen2.5-Coder. En synthèse Ce projet m'a surtout servi de terrain d'apprentissage sur l'IA locale. Faire tourner un modèle dans un onglet est désormais réaliste : WebGPU est disponible par défaut dans les versions récentes des principaux navigateurs, même s'il reste prudent de détecter sa présence et de prévoir un repli. Les modèles de quelques milliards de paramètres restent modestes, et c'est précisément ce qui rend l'exercice formateur : pour qu'un agent soit utile à cette échelle, il faut compenser par l'ingénierie, la contrainte de format, le RAG sur la documentation, la séparation entre décision et synthèse. J'attends d'ailleurs avec une certaine impatience le courriel triomphant de la personne persuadée d'avoir piraté mon serveur parce qu'elle a vu défiler la connexion SSH, tapé quelques commandes et décroché un prompt root avec un su. Je la remercie par avance pour son rapport : ce shell n'est qu'une simulation, il tourne intégralement dans son propre navigateur, et derrière, il n'y a justement aucun serveur à compromettre. Le tout est sous licence MIT et le dépôt est conçu pour être réutilisable : l'identité et la configuration tiennent dans un seul fichier, et le contenu visitable vit dans l'arborescence root/. Si vous voulez en faire votre propre portail terminal, ou simplement aller demander à Denree quelle est votre adresse IP, le code et la démo sont en ligne. Notes et références Terminal.com, dépôt du projet sur GitHub : https://github.com/ltoinel/Terminal.com ↩︎ Astro, le générateur de site statique utilisé : https://astro.build ↩︎ WebLLM, moteur d'inférence LLM dans le navigateur (projet MLC, licence Apache 2.0) : https://github.com/mlc-ai/web-llm ↩︎ WebGPU, l'API d'accès au GPU dans le navigateur (documentation MDN) : https://developer.mozilla.org/en-US/docs/Web/API/WebGPU_API ↩︎ Hugging Face, organisation officielle mlc-ai, où sont publiés les modèles au format MLC chargés par WebLLM : https://huggingface.co/mlc-ai ↩︎ La Soupe aux choux, film de Jean Girault (1981), d'où sont tirés le Glaude et la Denrée : https://fr.wikipedia.org/wiki/La_Soupe_aux_choux ↩︎ Afficher l’article complet
-
Bonjour, je pense que cet article devrait pouvoir t'aider : https://www.seomix.fr/prix-site-wordpress/
-
Je termine encore Platine cette semaine ici aussi.
-
Je termine encore Platine cette semaine.
-
Vivement le 1er juillet !!!
-
-
Win Traduction française de Mx7 pour Windows
Ldfa a répondu à un(e) sujet de Ldfa dans Traductions françaises de Maxthon sur Crowdin
Traduction approuvée. fr.ini -
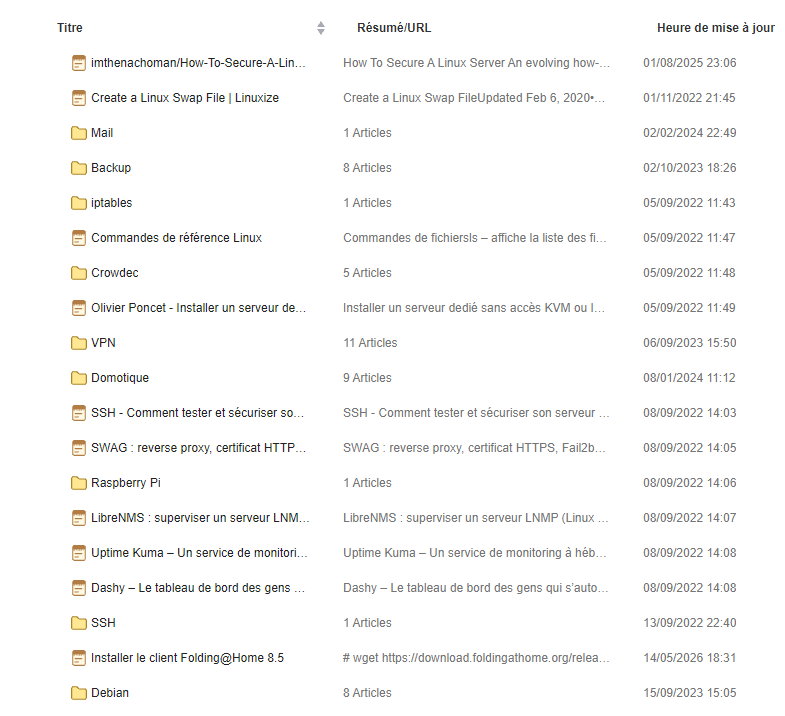
Est-ce que ça fonctionne chez vous ? Chez moi, le tri par date ou titre est complètement en désordre :
-
Win Traduction française de Mx7 pour Windows
Ldfa a répondu à un(e) sujet de Ldfa dans Traductions françaises de Maxthon sur Crowdin
There are new strings to translate in the Maxthon pour Windows project. You were a project participant previously so your help will be appreciated a lot. 1 new string for translation (6 words). -
Changements principaux : + Ajout de boutons de tri dans l'en-tête des listes de dossiers de Maxnote, permettant un tri rapide par titre, date de création et date de modification. - Correction de problèmes de synchronisation avec Maxnote V2 et de cas où le contenu d'une note pouvait apparaître vide. - Correction d'un problème empêchant la fenêtre contextuelle de la vidéo de se masquer lorsque la touche « Boss Key » était activée. - Correction d'un problème permettant d'accéder à une note via son lien partagé même après l'annulation du partage. - Correction d'un problème pouvant entraîner des erreurs lors d'une installation par écrasement. - Correction d'un problème pouvant empêcher le chargement de la barre latérale de Maxnote en raison d'un chargement prématuré. - Correction de plusieurs plantages connus.
-
Maxthon 7.5.2.8400 Bêta pour Windows est sorti aujourd'hui, il apporte son lot de nouvelles fonctionnalités, d'améliorations et de corrections de bugs. Téléchargement : https://github.com/maxthon/Maxthon/releases/ Les changements en français sont là. Vous pouvez également vous abonner au groupe Telegram NBdomain & MX6 pour faire remonter vos demandes d'améliorations et bugs rencontrés. Source : https://bbs.mxfast.com/d/1204-新版win-端-7528400-beta-版本发版
-
01net.com Publié le 20 juin 2026 Par Geoffroy Ondet 01net.com Environ 10 minutes de lecture Vous en avez marre d’utiliser un navigateur Web développé par Google, Microsoft ou Apple ? Remplacez Chrome, Edge et Safari par des navigateurs web européens ! Voici nos favoris. Pour arriver jusqu’à cette page, environ 63 % d’entre vous ont utilisé Chrome, 17 % ont utilisé Safari, 6 % ont utilisé Edge et 6 % se sont servis de Firefox. Tous ces navigateurs ont un point en commun. Ils sont tous développés par des entreprises américaines : Google, Microsoft, Apple, et dans le cas un peu particulier de Firefox, la Fondation Mozilla. © Statcounter Firefox est en effet un peu à part, parce qu’il est développé par une Fondation à but non lucratif, dont le siège se trouve à San Francisco. Mais Mozilla, par l’intermédiaire de Firefox, a fait de la protection des données de ses utilisateurs, son argument principal. Soyons clairs, si vous ne deviez choisir qu’un seul des navigateurs précédemment nommés, c’est bien évidemment sur Firefox que vous devriez jeter votre dévolu. Firefox, dont le code est ouvert, adopte une approche résolument orientée sur la confidentialité. Il propose une protection renforcée contre le pistage, bloque les cookies tiers, protège contre le fingerprinting (une technique permettant d’identifier un utilisateur sans l’utilisation des cookies), utiliser la technologie DNS-over-HTTPS par défaut, et embarque un système de conteneurs d’onglets, pour isoler certains sites du reste de la navigation. Par ailleurs, Firefox s’appuie sur son propre moteur de rendu, Gecko. Le problème du moteur de rendu Pour créer un navigateur Web, il faut un moteur de rendu. Et le problème principal, outre le coût que cela représente en matière de développement, c’est qu’il n’existe pour l’heure aucun moteur de rendu européen digne de ce nom. Il en existe trois qui sont majoritairement utilisés par l’ensemble des navigateurs Web grand public que vous utilisez sur votre ordinateur ou votre smartphone : Blink (Google), Webkit (Apple), et Gecko (Mozilla). S’il existe bien des navigateurs Web développés en Europe, vous n’en trouverez a priori aucun utilisant un moteur de rendu autre que ceux que nous venons de citer. À quelques exceptions près, sur Linux notamment. Ainsi, les navigateurs alternatifs que vous pouvez utiliser quotidiennement, utilisent, pour la grande majorité, soit le moteur de rendu de Google, Blink, soit le moteur de rendu de Mozilla, Gecko. C’est d’ailleurs aussi sur Chromium, la déclinaison open source de Chrome, ou sur Firefox, qu’ils sont généralement basés techniquement. Quel navigateur Web européen pour remplacer Chrome, Edge et Safari ? Trouver un navigateur Web développé en Europe, qui répondra à vos attentes et surtout, qui profite d’un suivi et de mises à jour de sécurité fréquentes n’est pas chose aisée. Nous en avons installé et testé plusieurs pour ne conserver que les plus intéressants. Voici notre sélection. 1. Vivaldi 🇳🇴 Vivaldi est un navigateur Web basé sur Chromium créé par l’entreprise Vivaldi Technologies située en Norvège, elle-même fondée par un certain Jon von Tetzchner, qui n’est autre que l’ancien co-fondateur d’Opera. Présenté comme une alternative aux géants de la Tech Vivaldi a fait de la sécurité et de la personnalisation son cheval de bataille. La philosophie de Vivaldi s’architecture ainsi principalement autour de la protection de la vie privée. Le navigateur ne suit pas le comportement en ligne des utilisateurs, ne génère aucun profil, et ne revend pas non plus leurs données. Toutes les données de navigation restent locales ou sont chiffrées, explique ainsi Vivaldi Technologies. Pour pouvoir compter ses utilisateurs sans les pister, Vivaldi utilise un identifiant unique généré à l’installation du navigateur et qui n’est combiné à aucune autre donnée personnelle. Contrairement aux navigateurs des géants américains, Vivaldi a pris le parti de ne pas intégrer de fonctionnalités liées à l’intelligence artificielle. L’entreprise qui développe Vivaldi est par ailleurs indépendante financièrement : elle appartient en effet à ses employés et ne dépend d’aucun investisseur externe. © 01net.com Depuis son lancement en 2015, Vivaldi s’est bâti une solide réputation dans le monde de la navigation Web. Vivaldi a en effet le mérite d’intégrer nativement de nombreux outils, et cela afin d’éviter d’avoir à recourir à des extensions tierces, et propose de très nombreuses options de personnalisation. Parmi les fonctionnalités les plus pratiques du navigateur, on retient, par exemple, la possibilité de juxtaposer des onglets ou de les empiler sur deux niveaux, ou encore la possibilité de créer des espaces de travail pour mieux organiser les pages ouvertes. Vivaldi embarque par ailleurs nativement un lecteur de flux RSS, un agenda ainsi qu’un client de messagerie électronique. Le navigateur intègre également un module de prise de notes synchronisable, un outil de capture d’écran, ou encore un module de traduction de pages respectueux de la vie privée. Le navigateur possède aussi une solide réputation en matière de personnalisation. Vous pouvez en effet modifier l’emplacement de presque tous les boutons, barres et panneaux. Ajoutez à cela la possibilité d’appliquer des thèmes graphiques et des extensions (natives, ou issues du Chrome Web Store), et vous obtenez un navigateur répondant parfaitement aux besoins individuels précis de chacun. Pour couronner le tout, Vivaldi dispose d’un VPN intégré, fourni par ProtonVPN, d’un bloqueur de publicités et de traqueurs, et d’un système de synchronisation chiffrée de bout en bout (hébergé sur des serveurs islandais), pour sauvegarder vos mots de passe, signets, notes, etc. Et, bonne nouvelle, le navigateur est disponible sur desktop (Windows, macOS et Linux), mais profite aussi d’une déclinaison mobile sur iOS et Android. 2. Mullvad Browser 🇸🇪 Mullvad Browser est un navigateur Web suédois conçu pour offrir un niveau de confidentialité équivalent à celui du navigateur Tor, mais optimisé pour une utilisation avec un VPN plutôt que par le réseau Tor. Il est d’ailleurs le fruit d’une collaboration entre Mullvad VPN et le Projet Tor. Gratuit et open source, il n’est disponible que sur desktop, sur Windows, macOS et Linux. Son objectif était de proposer aux utilisateurs de VPN un navigateur Web réduisant nativement le pistage et le profilage sans avoir à passer par les trois couches de relais du réseau Tor. À noter que Mullvad ne tire aucun revenu direct de son navigateur, mais uniquement de ses abonnements VPN. © 01net.com L’une des forces principales de Mullvad Browser est donc d’avoir une forte résistance à l’empreinte numérique laissée par votre navigation et qui permet aux sites Web de vous identifier. Pour y arriver, Mullbad Browser s’appuie sur plusieurs techniques. Tout d’abord Mullvad pratique le « Letterboxing ». Concrètement, il ajoute des barres grises autour des sites Web pour masquer la taille réelle de votre fenêtre de navigation, ce qui empêche les sites Web d’identifier la résolution de votre écran. Mullvad s’adonne également au spoofing des données matérielles. Il se charge en effet de les modifier, mais aussi de changer de fuseau horaire pour que tous les utilisateurs paraissent identiques. Le navigateur a également un système de protection contre le Canvas API. Il rend ainsi certains éléments flous pour empêcher l’extraction d’informations via la carte graphique de votre machine. Le but de l’opération ? Faire que tous ses utilisateurs apparaissent comme un seul individu aux yeux des traqueurs. Par défaut, Mullvad Browser applique plusieurs protections strictes, notamment un mode navigation privée activé en permanence, un blocage par défaut des traqueurs (via uBlock Origin), et une isolation des cookies tiers dans des conteneurs spécifiques. Par ailleurs, le navigateur ne collecte ni ne renvoie aucune donnée d’utilisation ou de performance à quiconque. À noter également que s’il embarque un gestionnaire de mots de passe et un système de synchronisation (ceux de Firefox, Mullvad étant en partie basé sur ce dernier), celui-ci est désactivé par défaut. 3. WaterFox 🇬🇧 WaterFox est un navigateur Web open source basé sur Firefox créé en 2011 au Royaume-Uni. Disponible sur Windows, macOS, Linux et Android (avec une prise en charge des extensions), il s’adresse aux utilisateurs exigeants qui recherchent un équilibre entre vie privée, personnalisation et contrôle, sans avoir à gérer manuellement des paramètres trop complexes. Dès l’installation WaterFox applique des règles de protection de la vie privée très strictes. WaterFox utilise, par exemple un relais DNS « Oblivious HTTP » qui a pour objectif de masquer le contenu de vos requêtes en chiffrant celles-ci, mais aussi votre identité auprès du résolveur DNS. Il supprime par ailleurs toute forme de télémétrie ou d’analyses quant à votre navigation. Waterfox intègre également un système de gestion automatisé des bannières de cookies (en rejetant celles-ci lorsque c’est possible), impose l’utilisation du HTTPS, et désactive les appels vers Google Safe Browsing par défaut pour éviter les fuites de données. © 01net.com WaterFox propose également plusieurs fonctionnalités qui requièrent en principe l’installation d’extensions tierces sur d’autres navigateurs. Il propose ainsi, en option, un affichage des onglets vertical et sous forme d’arborescence, avec des onglets « enfants » pour vous permettre de mieux organiser vos recherches. Il est aussi possible d’ouvrir n’importe quel onglet en navigation privée, sans avoir à ouvrir une nouvelle fenêtre de navigation. Par ailleurs, WaterFox permet de copier toutes les URL ouvertes en un seul clic, de décharger les onglets inactifs pour libérer de la mémoire, ou encore de redémarrer le navigateur en effectuant une purge du cache. Pour s’adapter à vos habitudes de travail, WaterFox propose une interface très flexible. Vous pouvez ainsi déplacer les barres d’onglets, de signet et d’état très facilement, appliquer différents thèmes graphiques prédéfinis, ou encore réaliser des modifications plus poussées en intervenant directement sur des fichiers de configuration. 4. Zen Browser 🇪🇸 Zen Browser est un navigateur Web basé sur Firefox lancé en 2024 et disponible uniquement sur Desktop (Windows, macOS et Linux). Imaginé par Mauro Baladés, un étudiant espagnol, Zen Browser a pour objectif de proposer un équilibre entre design, performance et respect de la vie privée. Le projet est open source et est maintenu par de nombreux contributeurs basés majoritairement en Europe. La principale particularité de Zen Browser est d’être conçu autour d’un système d’affichage d’onglets verticaux pour maximiser l’espace d’écran et améliorer la navigation. Il propose également un mode compact qui permet de masquer la barre d’onglet pour gagner encore plus de place à l’écran et permet d’organiser les onglets par projets au sein d’espaces de travail. Parmi les fonctions clés de Zen Browser, on peut retenir que celui-ci permet d’afficher une vue scindée pour afficher plusieurs sites web côte à côte, ou encore une fonction nommée Zen Glance grâce à laquelle vous pouvez prévisualiser rapidement un site sans avoir à quitter la page active. © 01net.com À noter également que le navigateur dispose d’une barre latérale détachable pour accéder rapidement à certains outils ou sites secondaires, et permet d’appliquer des thèmes graphiques créés par la communauté, téléchargeables depuis une boutique dédiée pour personnaliser l’interface du navigateur. Enfin, Zen Browser intègre la synchronisation de Firefox, ce qui vous permettra de récupérer facilement vos mots de passe, mais aussi vos signets et votre historique de navigation, à condition évidemment que vous disposiez d’un compte Mozilla. Seule ombre au tableau, pour l’heure Zen Browser est incapable de lire les contenus protégés par des DRM. Le navigateur ne possède en effet pas encore de licence Widevine qui lui permet de lire les contenus protégés sur des plates-formes comme Netflix, Amazon Prime Vidéo, Disney+, Spotify, Apple Music, etc. 5. Ecosia Browser 🇩🇪 Ecosia Browser est un navigateur Web basé sur Chromium dérivé du moteur de recherche du même nom. Fondé en Allemagne, il reprend la même philosophie que celle mise en avant par le moteur de recherche. Il reprend ainsi sa mission écologique directement dans l’expérience de navigation, visant à financer la plantation d’arbres grâce aux revenus publicitaires générés par les recherches de ses utilisateurs. © 01net.com Disponible sur Windows, macOS, Android et iOS, Ecosia met l’accent sur la protection des données de ses utilisateurs. Les recherches sont lancées nativement dans le moteur de recherche éponyme, avec la même rigueur dans le respect de la vie privée. Il permet également de suivre votre impact sur l’environnement en tant qu’utilisateur, et donne accès à des fonctions alimentées par « l’IA la plus écolo du monde ». Ecosia Browser utilise en effet une IA propulsée par des énergies vertes et qui s’appuie sur des modèles plus petits et plus rapides. Le navigateur embarque par ailleurs un système de protection visant à bloquer les traqueurs et les cookies, met à disposition un économiseur de mémoire, et peut également précharger certaines pages Web pour les afficher plus rapidement. À noter qu’il embarque aussi un économiseur d’énergie censée vous aider à prolonger l’autonomie de votre PC. 👉🏻 Suivez l’actualité tech en temps réel : ajoutez 01net à vos sources sur Google, et abonnez-vous à notre canal WhatsApp. Afficher l’article complet
-
Je suis en train de faire la MAJ vers Quasar, c'est un peu long en VDSL. La commande pour faire la MAJ : glf-update && glf-boot
-
Firefox Mozilla vient de cacher le bloqueur de pubs de Brave dans Firefox
Ldfa a répondu à un(e) sujet de Ldfa dans La famille Mozilla
Je pense que cette fonctionnalité n'est pas encore activée par défaut parce que c'est encore en cours de développement... -
Je n'ai jamais utilisé ce genre de prestation. J'ai utilisé des logiciels dédiés chez des hébergeurs, puis je suis passé à l'hébergement de mes serveurs de A & Z. Par contre, je ne suis pas graphiste, j'ai donc utilisé des thèmes gratuits ou payants, que je me suis contenté de personnaliser. Il faut regarder le coût de la création du site, ainsi que le coût mensuel de son hébergement et de sa maintenance (sauvegardes et MAJ du système d'exploitation). Je ne pourrai malheureusement pas plus te renseigner dans ce domaine.
-
Je termine encore Platine cette semaine ici aussi.
-
Je termine encore Platine cette semaine.
-
Changements principaux : + Nous avons mis à jour l'interface de connexion et ajouté la connexion par code de vérification. Vous pouvez désormais recevoir un code via votre compte et vous connecter rapidement depuis votre navigateur. * Reconnaissance optimisée des gestes de la souris. - Correction d'un problème qui pouvait entraîner la conversion des données de compte en données locales après la connexion. - Correction des échecs lors de l'enregistrement rapide d'images et mise à jour des invites d'enregistrement rapide afin d'utiliser le nouveau style de notification. - Correction de problèmes de performances dans Maxnote. - Correction d'un problème qui pouvait empêcher l'affichage des images des notes lors de leur première ouverture sur plusieurs appareils.
-
Maxthon 7.5.2.8200 Bêta pour Windows est sorti aujourd'hui, il apporte son lot de nouvelles fonctionnalités, d'améliorations et de corrections de bugs. Téléchargement : https://github.com/maxthon/Maxthon/releases/ Les changements en français sont là. Vous pouvez également vous abonner au groupe Telegram NBdomain & MX6 pour faire remonter vos demandes d'améliorations et bugs rencontrés. Source :